Publié par : Anaëlle Quivrin-Tessier — Rédactrice spécialisée en informatique
Lorsqu’un service tombe en panne, une erreur isolée explique rarement ce qui s’est passé. Les logs pour la gestion des incidents servent à reconstituer la chronologie, localiser le composant défaillant et vérifier le retour à la normale. Leur efficacité dépend toutefois moins du volume collecté que de leur qualité, de leur accessibilité et des liens établis entre les événements.
Reconnaître les informations qui rendent un log exploitable
Un log est un enregistrement d’activité produit par une application, un système d’exploitation, un serveur, un équipement réseau ou un terminal. Il peut décrire une connexion, une demande de fichier, un transfert, une erreur ou une opération utilisateur. Un fichier log rassemble ces enregistrements ; ceux-ci peuvent aussi être transmis directement à une plateforme de collecte.
Les journaux existent sous des formes structurées, semi-structurées ou non structurées. Pour l’investigation, l’essentiel reste de pouvoir répondre à quelques questions : quand l’événement s’est-il produit, sur quel composant, pendant quelle opération et avec quel résultat ?
- L’horodatage permet de replacer l’événement dans une séquence, à condition de maîtriser les fuseaux horaires et la synchronisation des systèmes.
- L’origine identifie le service, le serveur ou l’équipement concerné.
- Le message et la gravité décrivent l’action observée et son résultat.
- Le contexte, comme un identifiant de requête, facilite le rapprochement entre plusieurs composants.
À titre d’exemple, un journal indiquant qu’une requête de paiement échoue lors de l’accès à la base de données est plus utile qu’un simple message « erreur interne ». Il ne prouve pas encore la cause profonde : il désigne une piste à confronter aux autres événements.
Préparer la collecte avant que l’incident survienne
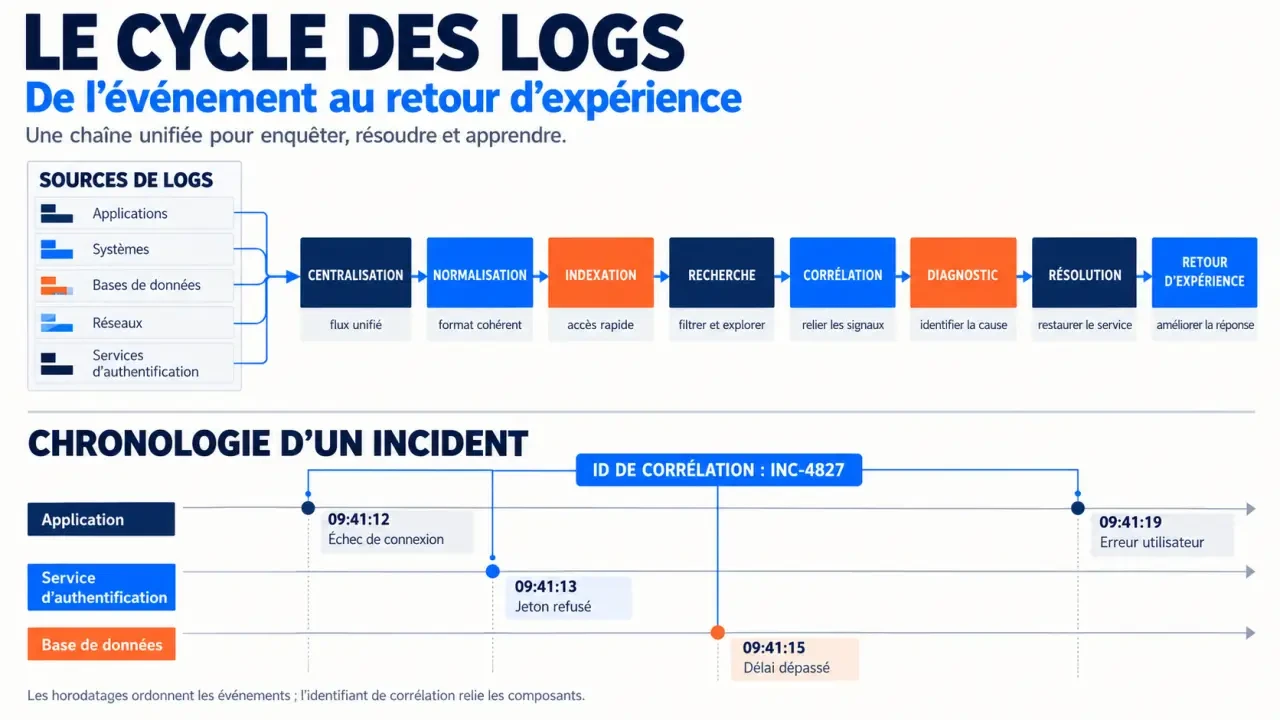
La gestion des logs couvre toute leur durée de vie : collecte, transmission, traitement, stockage, indexation, surveillance, analyse et suppression à l’échéance de conservation. Sans cette préparation, les équipes risquent de découvrir pendant une panne que les événements nécessaires sont introuvables ou déjà effacés.
Centraliser les sources réellement utiles
Commencez par les composants qui soutiennent les services critiques : applications, systèmes, bases de données, réseaux, endpoints et services d’authentification. Les journaux enregistrant les actions des utilisateurs complètent cette vue lorsque ces actions sont pertinentes pour le diagnostic ou la sécurité. La centralisation offre un point d’accès commun et évite de multiplier les connexions manuelles à des machines distinctes.
Normalisez ensuite les champs utilisés pour la recherche : date, nom du service, environnement, gravité et identifiant de corrélation. Centraliser ne suffit pas si chaque source nomme différemment la même information. Vérifiez également la collecte elle-même : une interruption de transmission peut créer un angle mort alors que les tableaux de bord semblent fonctionner.
Organiser la recherche et la conservation
L’indexation rend les champs interrogeables et accélère les filtres par période, composant ou opération. Les événements récents peuvent nécessiter un accès rapide, tandis que des archives moins sollicitées peuvent relever d’un stockage différent. Cet arbitrage doit tenir compte des investigations attendues, des coûts et des obligations applicables.
Définissez les durées de rétention avec les responsables techniques, sécurité et conformité. Il n’existe pas de durée universelle adaptée à tous les journaux. Documentez aussi qui peut consulter, exporter et supprimer les données : un accès centralisé ne signifie pas un accès sans restriction.
Passer de l’alerte à une hypothèse vérifiable
Une investigation efficace part d’un symptôme précis : opération impossible, latence inhabituelle ou échecs d’authentification. Rechercher indistinctement toutes les erreurs produit souvent davantage de bruit que de réponses. Mieux vaut construire progressivement une chronologie et tester une hypothèse à la fois.
- Délimiter l’incident : préciser le service touché, l’environnement, la période et l’impact utilisateur.
- Rechercher les événements associés : filtrer par composant, type d’opération et identifiant de requête lorsqu’il existe.
- Remonter avant le symptôme : chercher un changement de configuration, un redémarrage ou une première défaillance.
- Confronter les indices : vérifier si d’autres sources confirment l’hypothèse plutôt que de retenir le premier message inquiétant.
- Contrôler la correction : observer les logs et le fonctionnement du service après l’action de rétablissement.
Le bon filtre agit comme un ciseau : il découpe une fenêtre d’investigation dans la masse des événements. Mais une coupe trop serrée supprime les indices situés aux marges. Conservez donc une période avant et après l’erreur, puis élargissez-la si nécessaire. Cette marge aide à distinguer l’événement déclencheur, les erreurs en cascade et les tentatives automatiques de reprise.
Imaginons un paiement indisponible. Les logs applicatifs montrent des délais d’attente vers la base ; les journaux système signalent une pression sur les ressources ; un événement d’exploitation indique un changement récent. Cet ensemble construit une piste, pas une certitude. L’équipe doit encore vérifier le lien causal et mesurer l’effet de la correction avant de conclure.
Relier les logs aux métriques et aux traces pour réduire le MTTR
Les logs détaillent des événements, mais ne donnent pas seuls toute la vue du système. Le monitoring surveille des indicateurs et déclenche des alertes selon les règles définies. L’observabilité vise à comprendre l’état interne d’un système à partir de sa télémétrie, notamment en rapprochant métriques, événements, logs et traces.
| Signal | Apport pendant l’incident |
|---|---|
| Métriques | Repérer une hausse de latence, d’erreurs ou de consommation de ressources. |
| Logs | Examiner les opérations et messages associés à la dégradation. |
| Traces | Suivre le parcours d’une requête entre plusieurs services. |
| Événements d’exploitation | Replacer un déploiement ou un changement dans la chronologie. |
Dans une approche en silos, chaque équipe consulte son outil et rapproche manuellement les résultats. Une démarche d’observabilité full-stack facilite la navigation entre ces signaux sur l’ensemble de la chaîne technique. Elle aide notamment à distinguer le service qui affiche l’erreur du composant qui la provoque.
Pour évaluer une solution centralisée, testez un incident représentatif : peut-on retrouver une requête, passer à sa trace, comparer les métriques et partager la recherche ? La réduction du MTTR, ici le temps moyen de résolution, doit être mesurée sur les incidents réels. Elle ne découle pas automatiquement de l’achat d’un outil.
Exploiter les journaux pour la sécurité et le retour d’expérience
Les logs de sécurité et d’audit aident à examiner des connexions inhabituelles, des changements de privilèges ou des accès sensibles. Une répétition d’échecs peut justifier une investigation, sans constituer à elle seule la preuve d’une attaque. La priorité dépend aussi du compte concerné, de l’actif visé et des autres événements observés.
Ces journaux peuvent contenir des informations sensibles. Évitez d’y inscrire des secrets, limitez les données personnelles au nécessaire et protégez leur consultation ainsi que leur intégrité. Pour un audit, leur intérêt repose sur la traçabilité et la disponibilité des éléments pertinents ; collecter des logs ne garantit pas, à lui seul, la conformité.
Après résolution, conservez une synthèse de l’incident : impact, chronologie, hypothèses vérifiées, action corrective et contrôles de rétablissement. Repérez les champs manquants et les alertes trop bruyantes. Ce retour d’expérience transforme les journaux en levier d’amélioration : la prochaine investigation doit commencer avec de meilleurs indices, pas seulement davantage de données.